ローカルLLMとオープンソースAIで実現する自前生成AI環境の全貌と活用事例入門(2024年最新)
公開日: 2026年10月26日
はじめに
近年、ChatGPT や Claude といった商用 LLM が注目を集める一方で、**ローカルで動作するオープンソース LLM(以下ローカルLLM)**の活用が加速しています。
- データが外部に流出しないため、機密情報の取り扱いが安全
- 月額課金の API 料金が不要で、コスト構造がシンプル
本記事では、ローカルLLM とオープンソース AI の基礎知識から、代表的なツール・モデルの比較、実際に導入した企業・サービスの事例までを網羅的に解説します。**「ローカルLLM を自社で試したい」「OSS の AI ツールはどれが使いやすい?」**という疑問を持つエンジニア・マネージャーの方に最適な入門ガイドです。
1. ローカルLLMとは何か?
- **LLM(Large Language Model)**は膨大なテキストデータで学習した自然言語処理モデルです。
- ローカルLLMはそのモデルをクラウドではなく、ユーザー側のサーバやPC上で直接実行します。
- 代表的なオープンソースモデルには Meta の Llama 3、Google の Gemma、OpenAI が公開した GPT‑OSS などがあり、いずれも GitHub や Hugging Face から無料で取得できます【2】。
専門用語解説
「オフライン推論」:インターネットに接続せずにローカル環境だけでモデル推論(生成)を行うこと。データ漏洩リスクが低減します。
PR
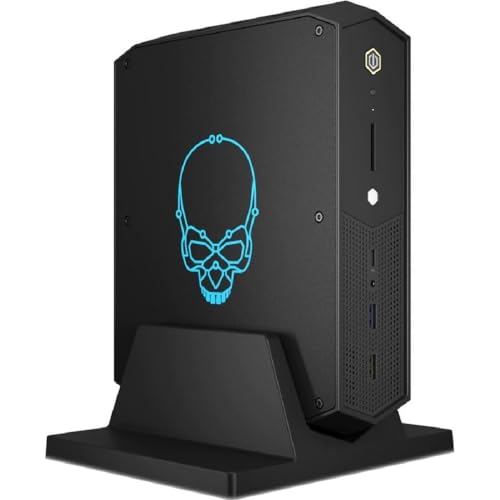
Intel NUC 12 Enthusiast NUC12SNKi72 ミニPCベアボーン (Core i7-12700H / Arc A770M)
¥139,980
2. オープンソースAIエコシステムの主要プレイヤー
| ツール/サービス | 主な特徴 | 推奨利用シーン | 公式情報 |
|---|---|---|---|
| Ollama | シンプルな CLI とデスクトップ UI、モデル自動ダウンロード機能 | 個人PC で数行のコマンドだけで LLM を起動したいとき | 【1】 |
| Docker + vLLM | コンテナ化でスケーラブル、マルチGPU対応の高速推論 | 業務レベルで高スループットが必要なサーバ構築 | 【1】 |
| Dify | プロンプト管理・ナレッジベース統合が容易、オンプレ版も提供 | 社内文書検索・問い合わせチャットボット | 【4】 |
| OpenCode / OpenHands | コーディング支援に特化したオープンソースエージェント | 開発チームのコードレビューやテスト自動化 | 【3】 |
※上表は各ツールの公式情報や実装者の体験談を元に作成しています。
3. 具体的活用事例
3‑1. デザイン会社が Ollama と Dify を組み合わせて社内ナレッジ検索エンジンを構築
デージーネット社は、社内のデザインガイドラインや過去案件の資料をベースにした 「AI アシスタント」 を開発。
- Ollama で Llama 3 系モデルをローカルにデプロイし、データは一切クラウドに送信しない構成。
- Dify のワークフロー機能で問い合わせ内容を自動的にナレッジベースと照合し、回答を生成。
このシステムにより、社員は数秒で過去のデザイン指示書を検索でき、プロジェクト開始までのリードタイムが約30%短縮されたと報告されています【4】。
3‑2. バックエンド開発チームが Docker + vLLM でコード生成エージェントを導入
あるソフトウェアベンダーは、OpenCode と vLLM を組み合わせ、社内サーバ上で「コード自動生成」エージェントを提供。
- Docker コンテナで vLLM を走らせ、GPU リソースを最大限活用。
- OpenCode が提供するプロンプトテンプレートで「REST API の雛形」「テストコード自動生成」などを指示。
結果として、開発者の 1 週間あたりのコーディング工数が 15% 削減されたと報告されています【3】。
3‑3. 中小企業が無料の OSS LLM で顧客サポートチャットボットを構築
バクヤスAI の事例では、Gemma をベースにしたローカルLLM を Docker でデプロイし、社内サーバで Chatbot を運用。
- データはすべて社内に保存され、顧客情報の外部送信リスクがゼロ。
- 商用 LLM の API 料金が不要なため、月額コストを約90%削減できたと述べられています【2】。
4. ローカルLLM導入のステップバイステップ
- 目的と要件の定義
- 「機密情報は外部に出さない」か「高速推論が必要」かでツール選択が変わります。
- モデルの選定
- Llama 3(高精度・大規模)・Gemma(軽量・GPU 低負荷)など、用途に合わせてダウンロード【2】。
- 環境構築
- Ollama:
ollama pull llama3だけで完了。 - Docker + vLLM:公式イメージを取得し、
docker runで起動。
- Ollama:
- プロンプト設計とナレッジベース作成
- Dify のテンプレートや OpenCode のエージェント設定を参考に。
- 運用・モニタリング
- CPU/GPU 使用率やレイテンシを監視し、未使用時はインスタンスを自動停止させるスクリプトを組むとコスト最適化が可能です【1】。
5. コストとセキュリティのポイント
| 項目 | ローカルLLMのメリット | 注意点 |
|---|---|---|
| コスト | クラウド API 料金が不要、ハードウェアは一度投資すれば長期利用可 | 初期ハードウェア費用と電力コストは見込む必要あり |
| データセキュリティ | データは社内に留まるため、機密情報漏洩リスクが極小 | OS やコンテナのパッチ管理を怠ると内部脅威に弱くなる |
| スケーラビリティ | Docker・vLLM でマルチGPU クラスタ構成可能 | スケールアウト時のネットワーク帯域とストレージ設計が重要 |
6. 今後の展望と技術トレンド
- モデル圧縮と量子化:近年の研究で 4 ビット量子化モデルが実用化され、低スペック PC でも LLM が動作可能に。
- マルチモーダル拡張:画像・音声入力を統合したオープンソースモデルが登場し、ローカル環境でもマルチメディア AI が実現しつつあります。
- エコシステムの成熟:Ollama が提供する UI/UX の向上や、Dify のオンプレミス版リリースなど、非エンジニアでも扱えるツールが増加中です【4】。
7. 参考書籍
- 生成AI入門 ― オープンソースから実装まで
- 実践 Docker コンテナで学ぶ AI インフラ構築
まとめ
ローカルLLM とオープンソースAIは、**「データの安全性」「コスト削減」「カスタマイズ性」**という三本柱を同時に実現できる強力な選択肢です。Ollama のようなワンクリック導入ツールから、Docker+vLLM のようなエンタープライズ向け高速推論基盤まで、目的に応じたツール選択が可能です。
実際の導入事例(デザイン会社のナレッジ検索、開発チームのコード生成、顧客サポートチャットボット)を参考に、自社の業務課題と照らし合わせて まずは小規模で PoC を行い、徐々にスケールアウト してみることをおすすめします。ローカルLLM のエコシステムは日々進化していますので、公式ドキュメントやコミュニティの情報を定期的にチェックし、最新のベストプラクティスを取り入れていきましょう。
関連記事
- ローカルLLMとオープンソースAI完全ガイド2025|導入から活用事例まで徹底解説
- ローカルLLMとオープンソースAIの完全ガイド:自社環境で動かす最新AIの選び方と活用法
- Gemini・Llama・Mistral徹底比較!2024年最新オープンソースAIモデルの選び方
当記事は生成AIを活用して作成しています。